01
顔が見える写真を用意
顔が隠れていない成人一人の鮮明な写真を使います。全身写真が適しています。
ブーツの着地からサングラス越しの視線までを、ニューヨークの横画面でつなぎます。
別のモデルページで設定を選び、プロンプトを入力できます。
新しく生成する動画は約12.12秒で、16:9・720p。参照映像の音声が付きます。
ブーツの着地からサングラス越しの視線までを、ニューヨークの横画面でつなぎます。
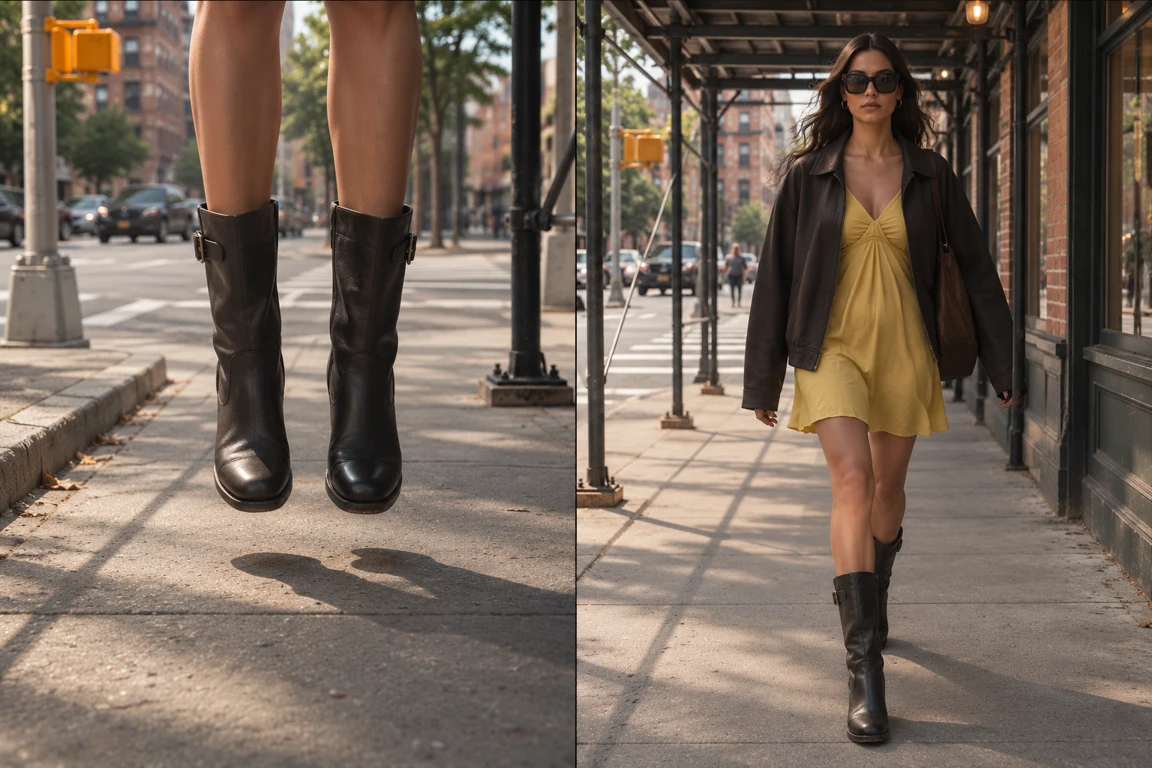
緑の足場が組まれた歩道を低い位置から映す。黒いフリンジ付きのロングブーツが上から降り、靴底が着地すると膝が曲がる。
淡い黄色のドレスと開いた黒い革コートを通ってサングラスまでカメラを上げる。人物が進む方向と逆にカメラを動かし、両手で髪をかき上げる動きも映す。
街並み、光、服装を保つ。片手でサングラスを少し下げてレンズを見つめ、そのまま参照と同じテンポで最後の数歩を踏む。
顔が隠れていない成人一人の鮮明な写真を使います。全身写真が適しています。
着地とカメラの動き、最後の視線を保ち、小物の細部を指定できます。
生成前に必要なクレジット数を確認します。
生成前の質問
顔が隠れていない成人一人の鮮明な写真を使います。全身写真が適しています。
新しく生成する動画は約12.12秒で、16:9・720p。参照映像の音声が付きます。
街並み、光、服装を保つ。片手でサングラスを少し下げてレンズを見つめ、そのまま参照と同じテンポで最後の数歩を踏む。
着地とカメラの動き、最後の視線を保ち、小物の細部を指定できます。
ブーツの着地からサングラス越しの視線までを、ニューヨークの横画面でつなぎます。