描述您想要生成的内容
GPT-4o Image – OpenAI 原生多模态图像生成
OpenAI 的 gpt-image-1 模型由 GPT-4o 驱动,为对话式 AI 带来原生图像生成能力。通过自然对话创建和精修图像,渲染精准文字,跨多种风格生成—全部来自单一多模态基础。
查看 GPT-4o Image 实战表现
对话式精修、多风格生成和精准文字渲染的真实示例。
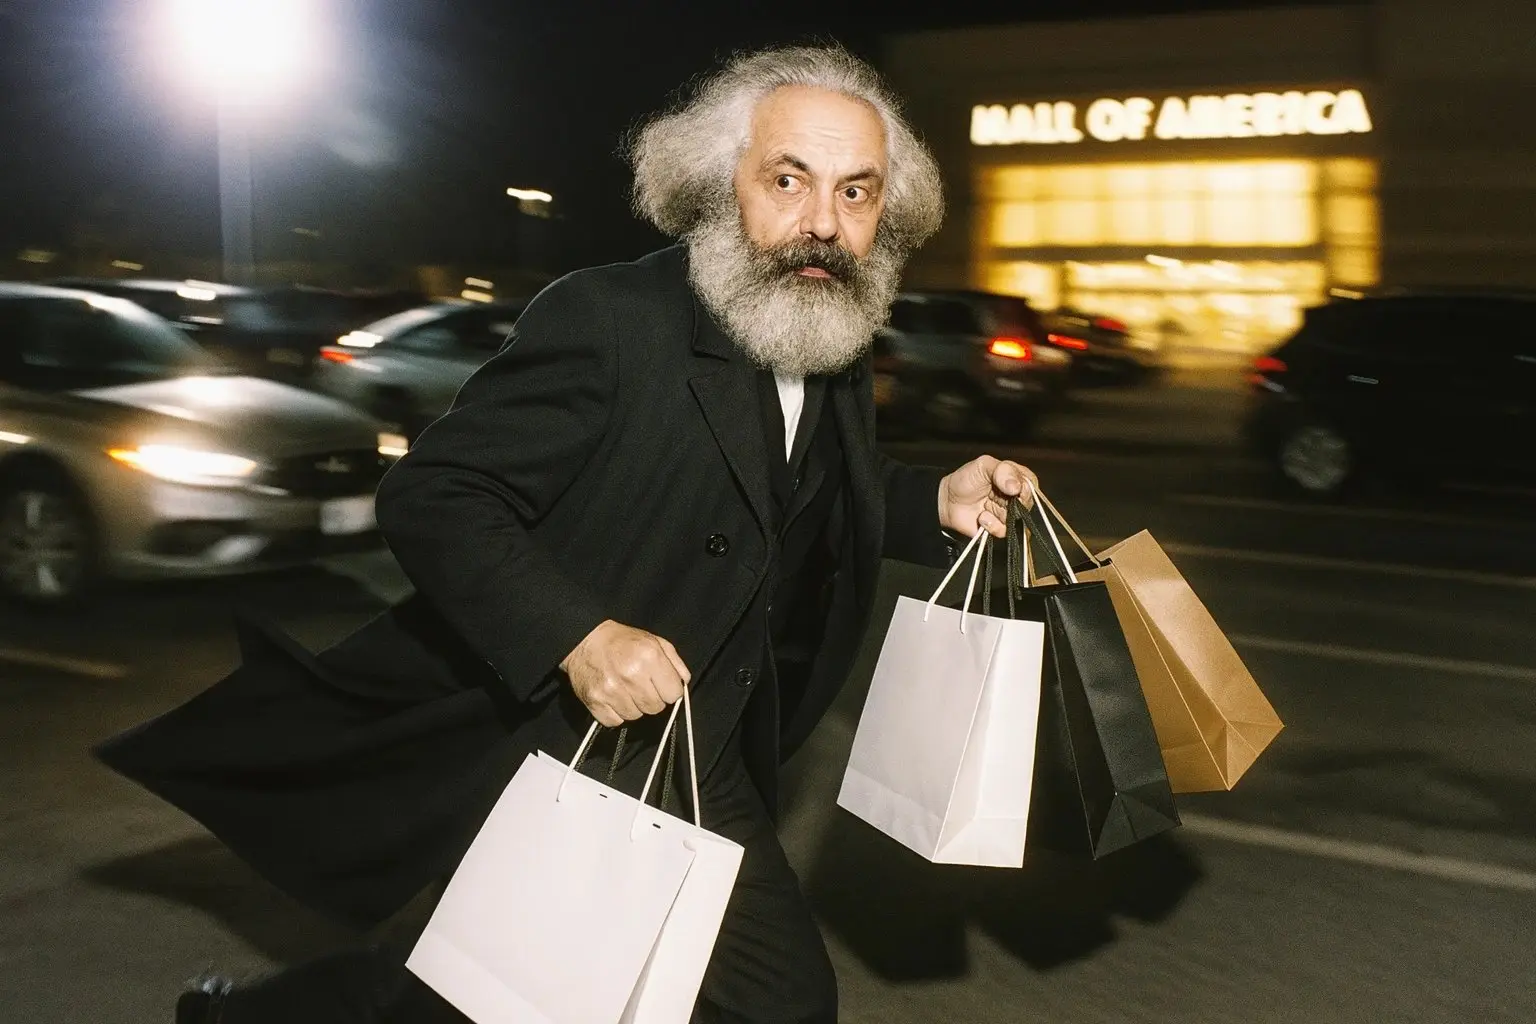
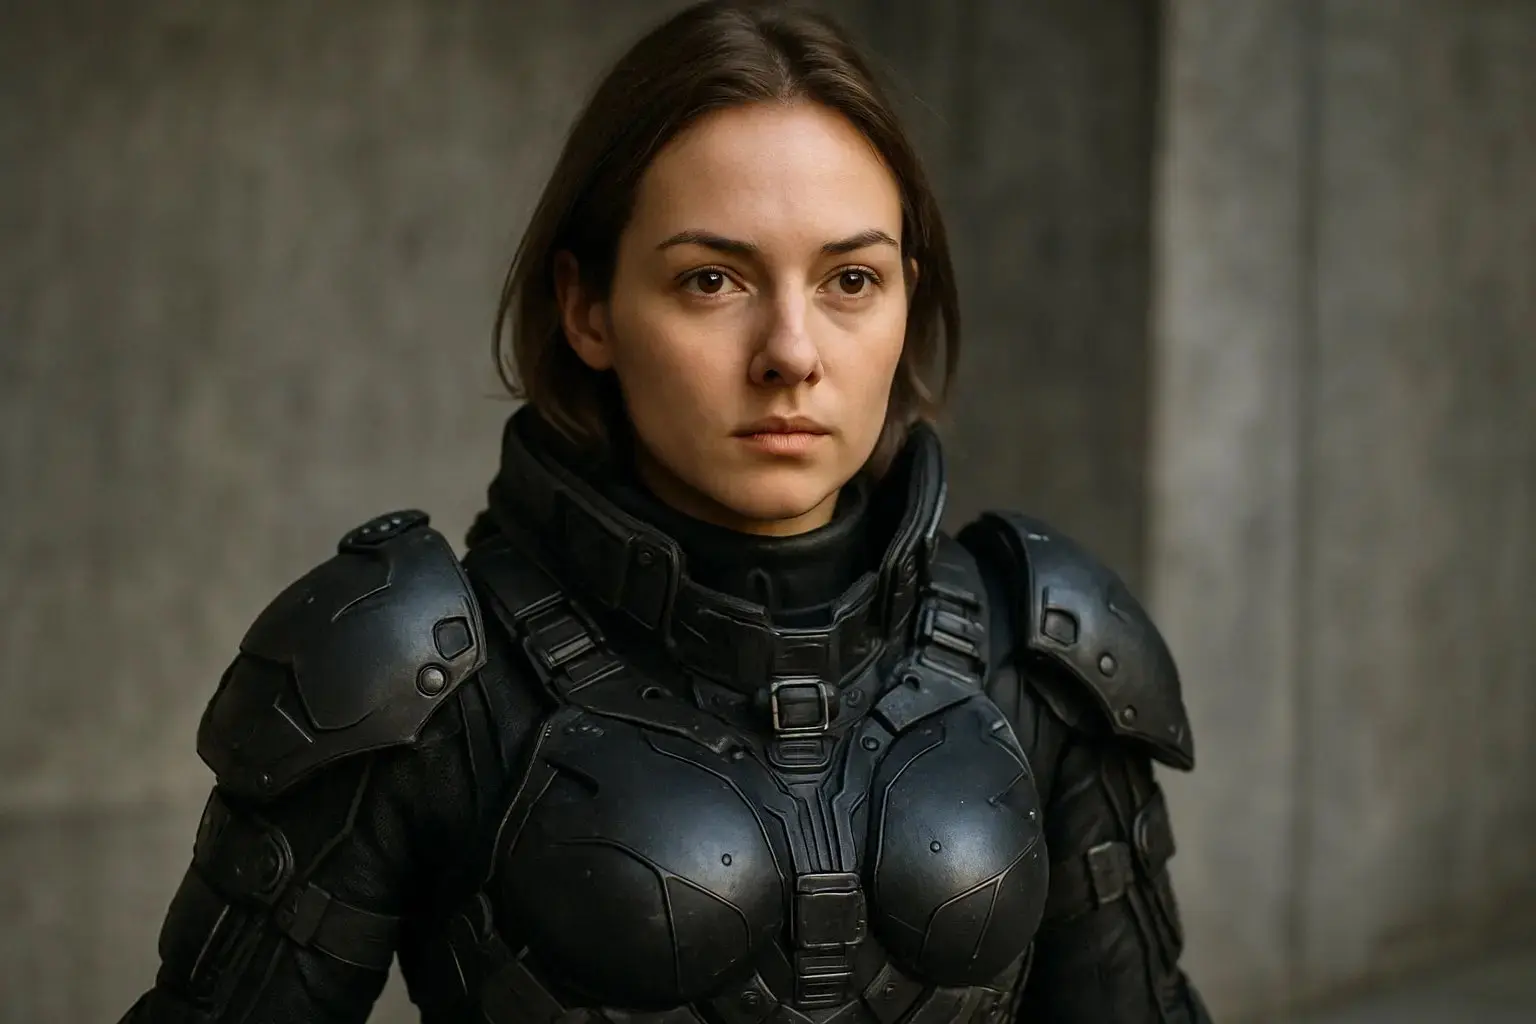
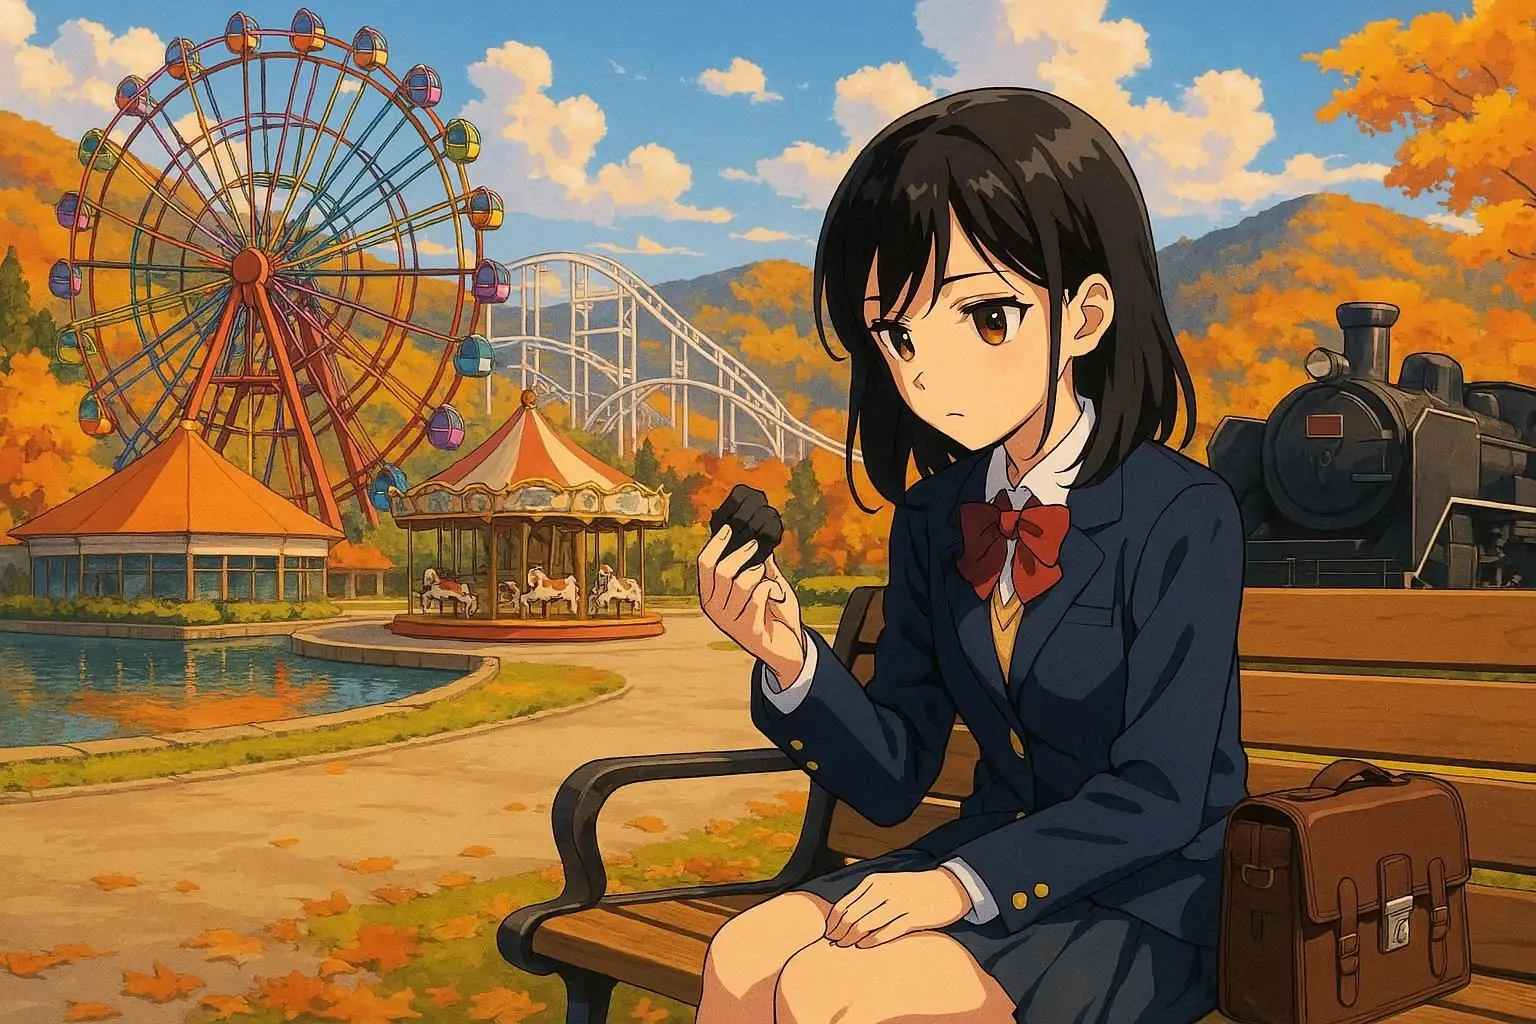
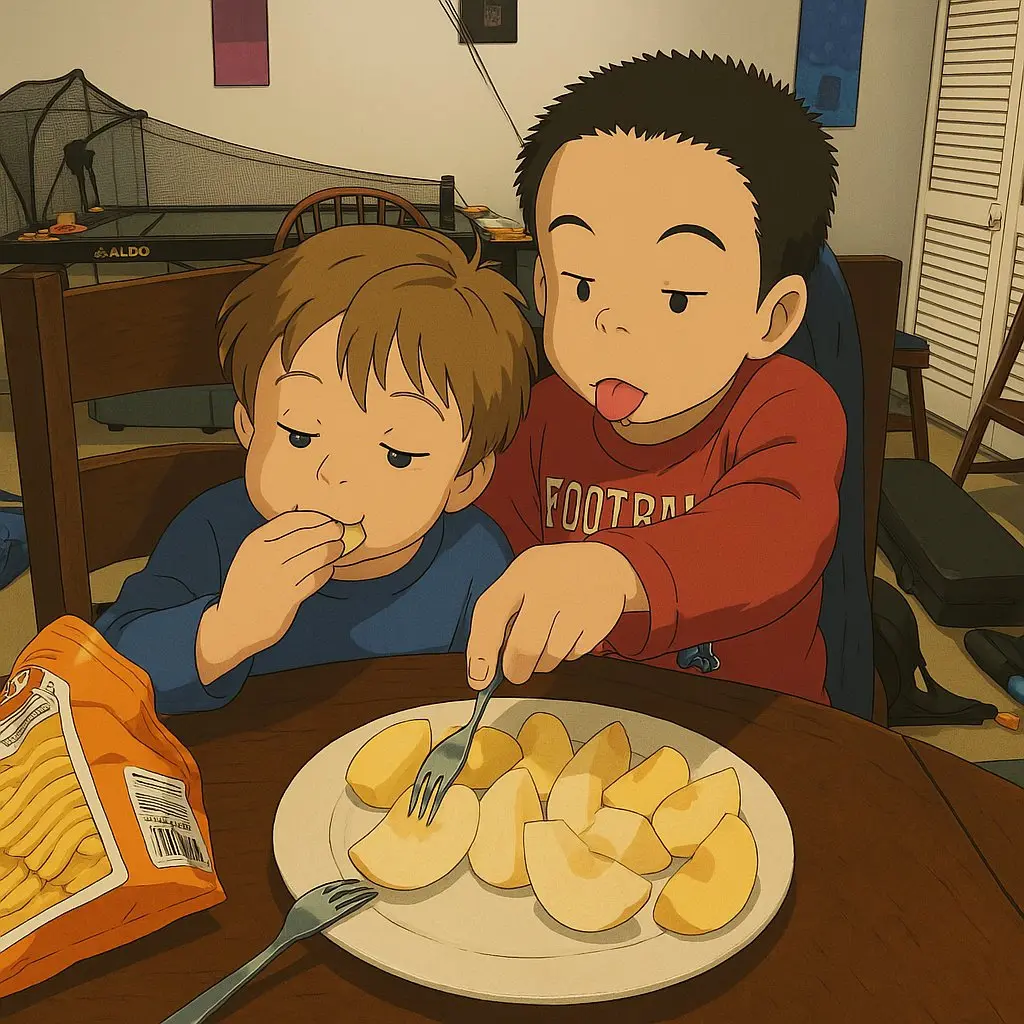
对话式图像精修
卓越的文字渲染与提示词遵循
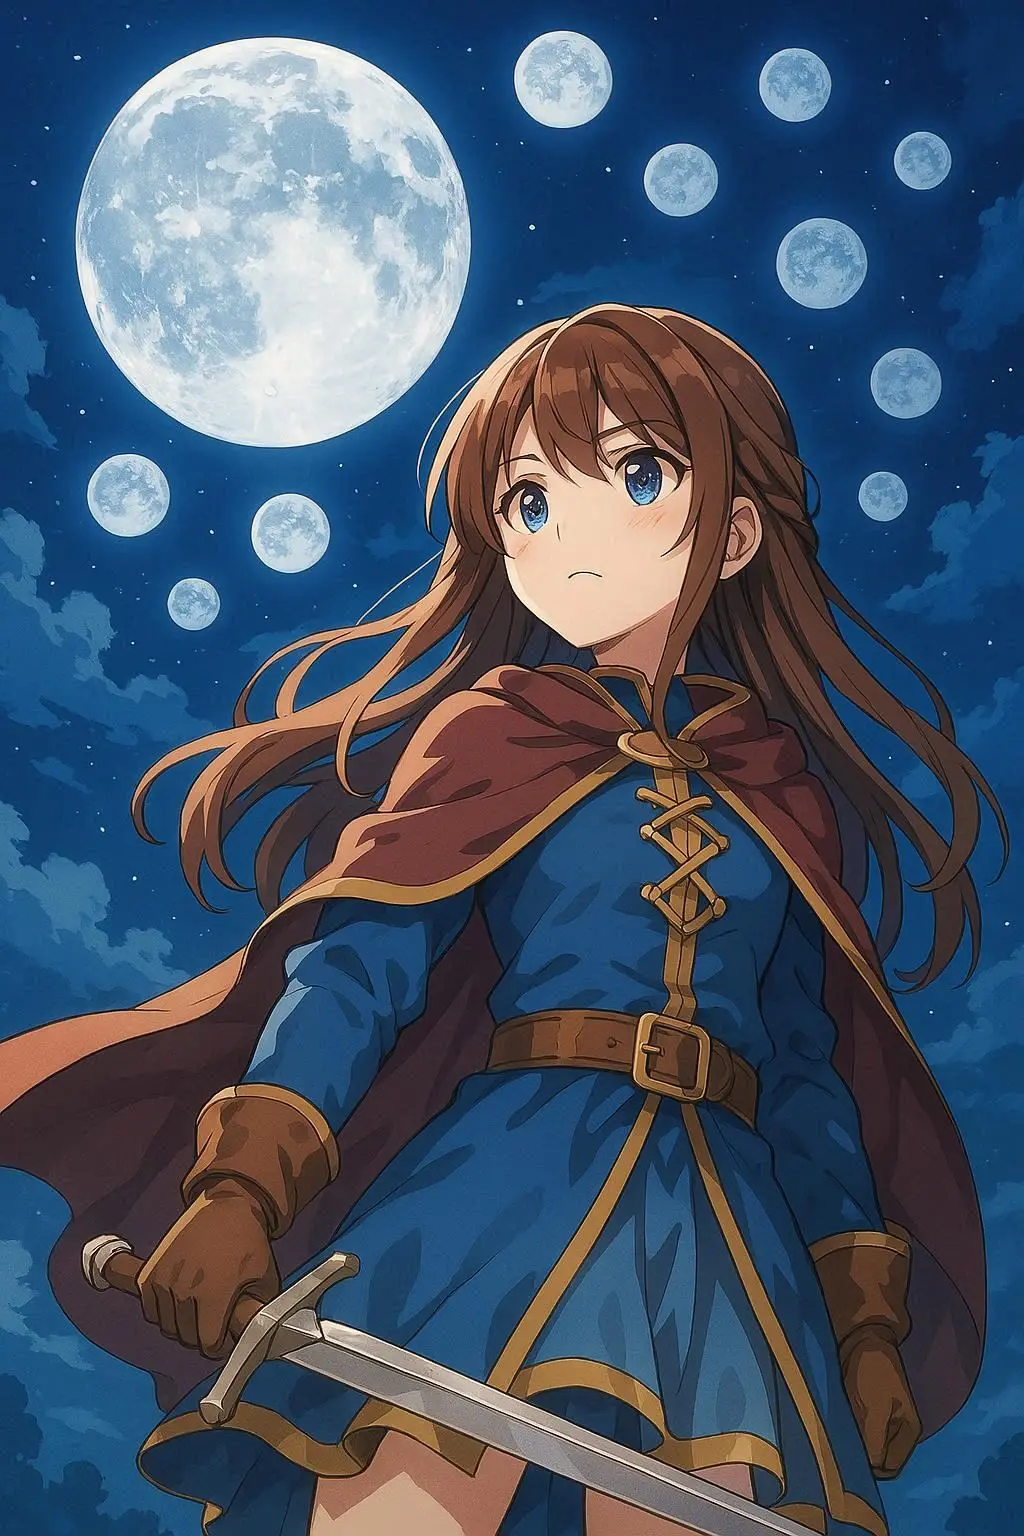
高分辨率输出与图像理解
由 GPT-4o 驱动的功能
使 GPT-4o Image 在生成模型中独树一帜的先进能力。
原生多模态
基于 GPT-4o 基础构建,将图像生成作为原生模态处理,而非外部工具调用。
对话式精修
通过自然对话精修图像,具有完整的上下文感知—GPT-4o 记住并在先前生成的基础上构建。
卓越的文字渲染
在图像中精准渲染文字,适用于海报、标志、信息图和品牌图形。
多风格生成
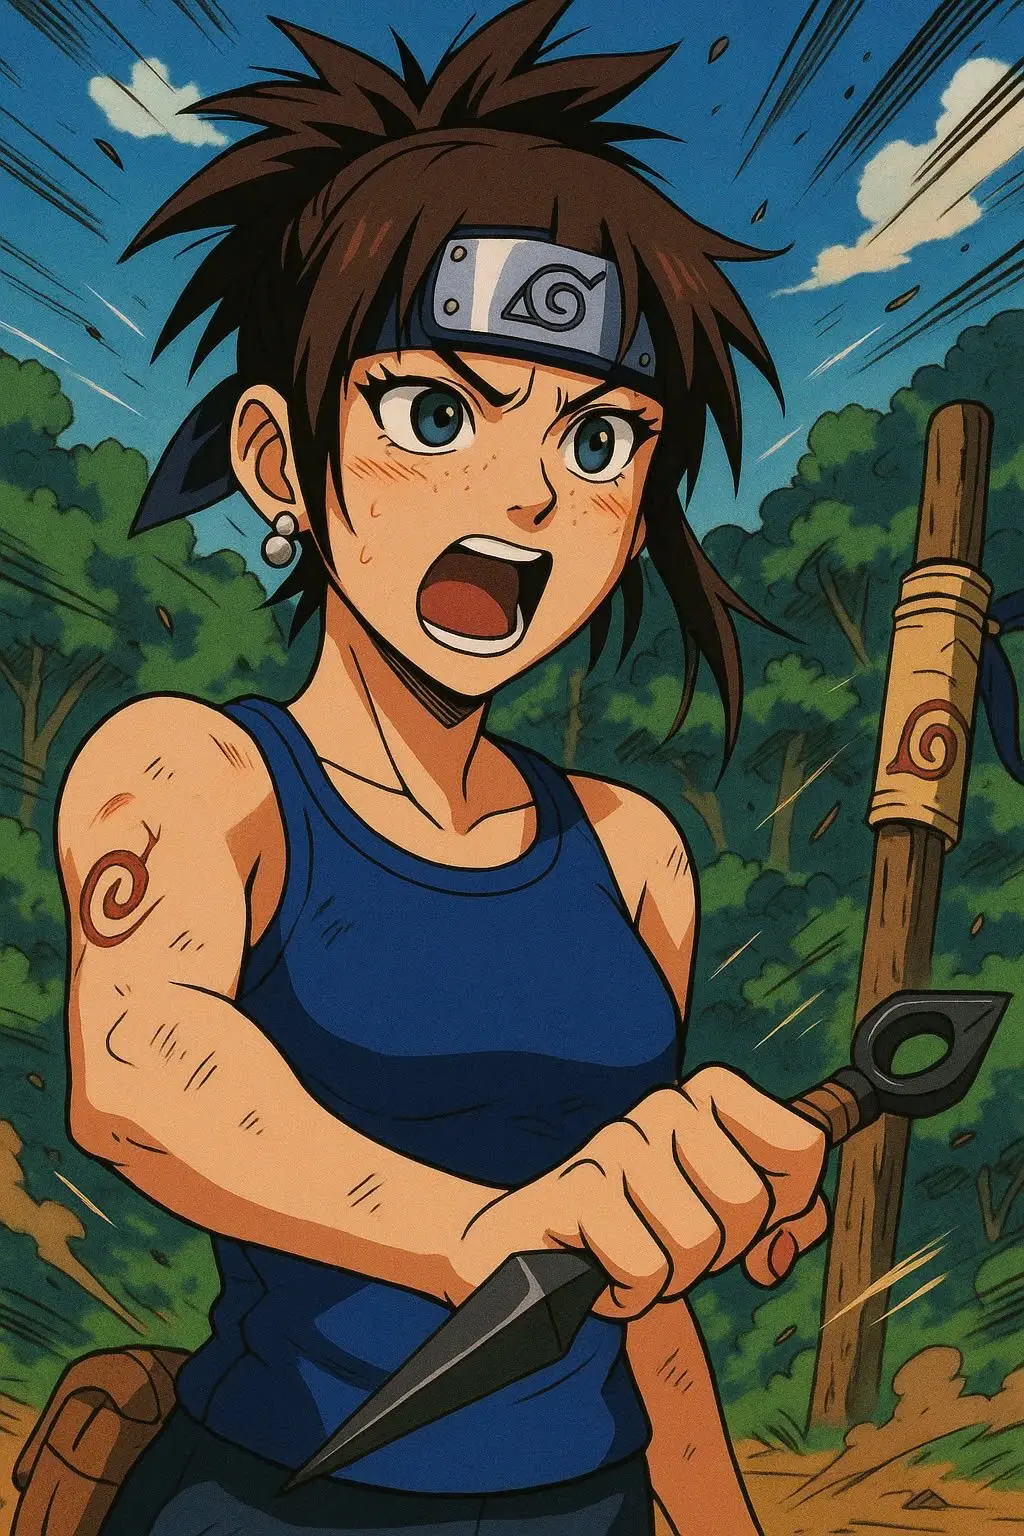
从同一端点生成逼真、插画、动漫、矢量、3D 和数据可视化风格。
4K 分辨率支持
创建高达 4096×4096 像素的图像,适用于专业级交付成果和印刷级内容。
图像分析集成
上传图像供 GPT-4o 分析并用作视觉上下文,转换或从现有资产中汲取灵感。
GPT-4o Image 工作原理
通过对话创建和精修专业图像的四个简单步骤:
开始对话
用自然语言描述您的创意。如需要可上传参考图像—GPT-4o 将分析并整合其细节。
选择风格与设置
指定风格(逼真、插画、动漫、矢量、3D、数据可视化)并选择分辨率、纵横比和变体数量。
生成与审查
GPT-4o 利用其知识库和聊天上下文创建高质量图像,实现准确、明智的结果。
通过对话精修
继续对话进行迭代—调整细节、更换风格或在先前生成的基础上构建,同时保持上下文。
GPT-4o Image 常见问题
关于 OpenAI 原生多模态图像生成模型的常见问题。
什么是 GPT-4o Image(gpt-image-1)?
GPT-4o Image 是 OpenAI 的原生多模态图像生成模型,于 2025 年 4 月发布。基于 GPT-4o 基础构建,它将图像生成作为原生能力处理,而非调用外部模型,支持对话式精修和上下文感知迭代。
这与 DALL-E 有何不同?
与使用扩散方法并作为独立模型运行的 DALL-E 不同,gpt-image-1 原生于 GPT-4o 的多模态架构,使用自回归生成。这支持对话式工作流、上下文感知和与聊天历史的无缝集成。
可以通过对话精修图像吗?
可以—GPT-4o Image 支持通过自然对话进行迭代精修。模型记住聊天上下文和先前的生成,允许您以对话方式在图像上构建,而非每次从头开始。
可以生成哪些风格?
GPT-4o Image 从一个端点支持多种风格:逼真、插画、动漫、矢量艺术、3D 渲染和数据可视化。只需在提示词中指定您想要的风格。
文字渲染如何工作?
GPT-4o Image 擅长在图像中精准渲染文字,非常适合海报、标志、信息图和品牌内容。文字呈现清晰可读,精确遵循您的提示词。
支持什么分辨率?
该模型生成高达 4096×4096 像素(4K 分辨率)的图像,适用于专业级、印刷级输出,适合演示文稿和高分辨率显示。
可以上传参考图像吗?
可以—上传图像供 GPT-4o 分析并整合到其理解中。模型可以转换上传的图像或将其用作风格和构图指导的视觉灵感。
可以商用图像吗?
可以。所有生成的图像均归您所有,可在营销活动、产品、网站、社交媒体或客户项目中商用,无需支付版税。
用 OpenAI 多模态 AI 创作
加入使用 GPT-4o Image 进行对话式图像生成、多风格创作和上下文感知精修的创作者行列。