生成したいものを記述してください
GPT-4o Image – OpenAIのネイティブマルチモーダル画像生成
GPT-4oを搭載したOpenAIのgpt-image-1モデルは、会話型AIにネイティブな画像生成をもたらします。自然な対話を通じて画像を作成・改良し、正確なテキストをレンダリングし、複数のスタイルで生成します。すべてが単一のマルチモーダル基盤から実現されます。
GPT-4o Imageの実例
会話型改良、マルチスタイル生成、正確なテキストレンダリングの実例。
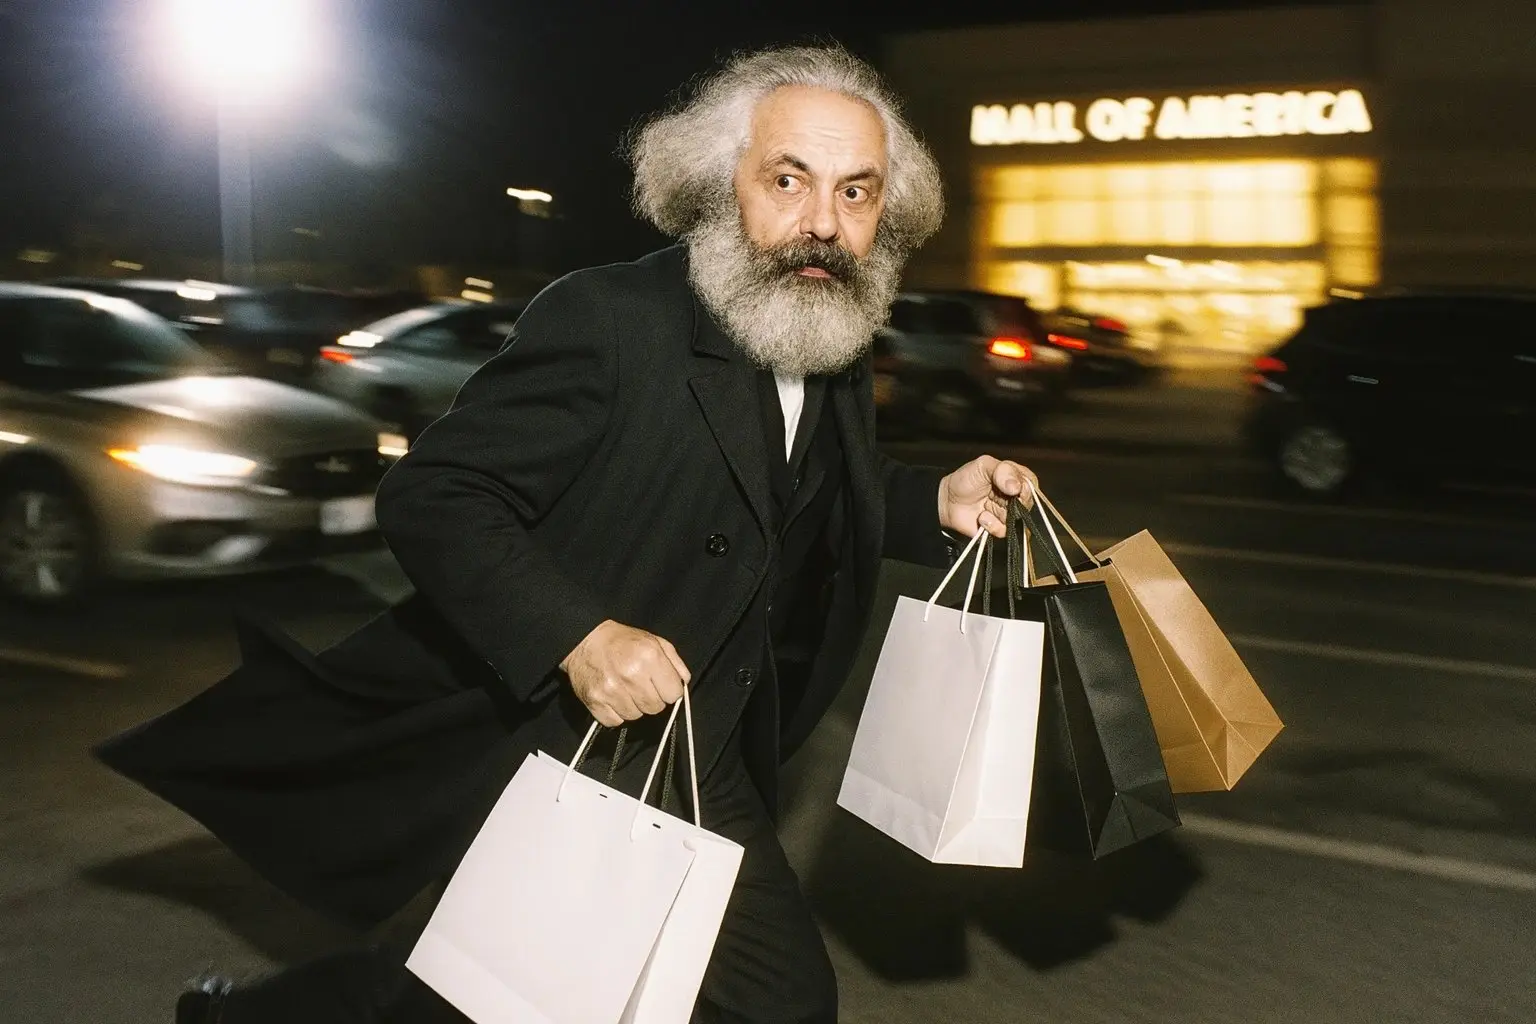
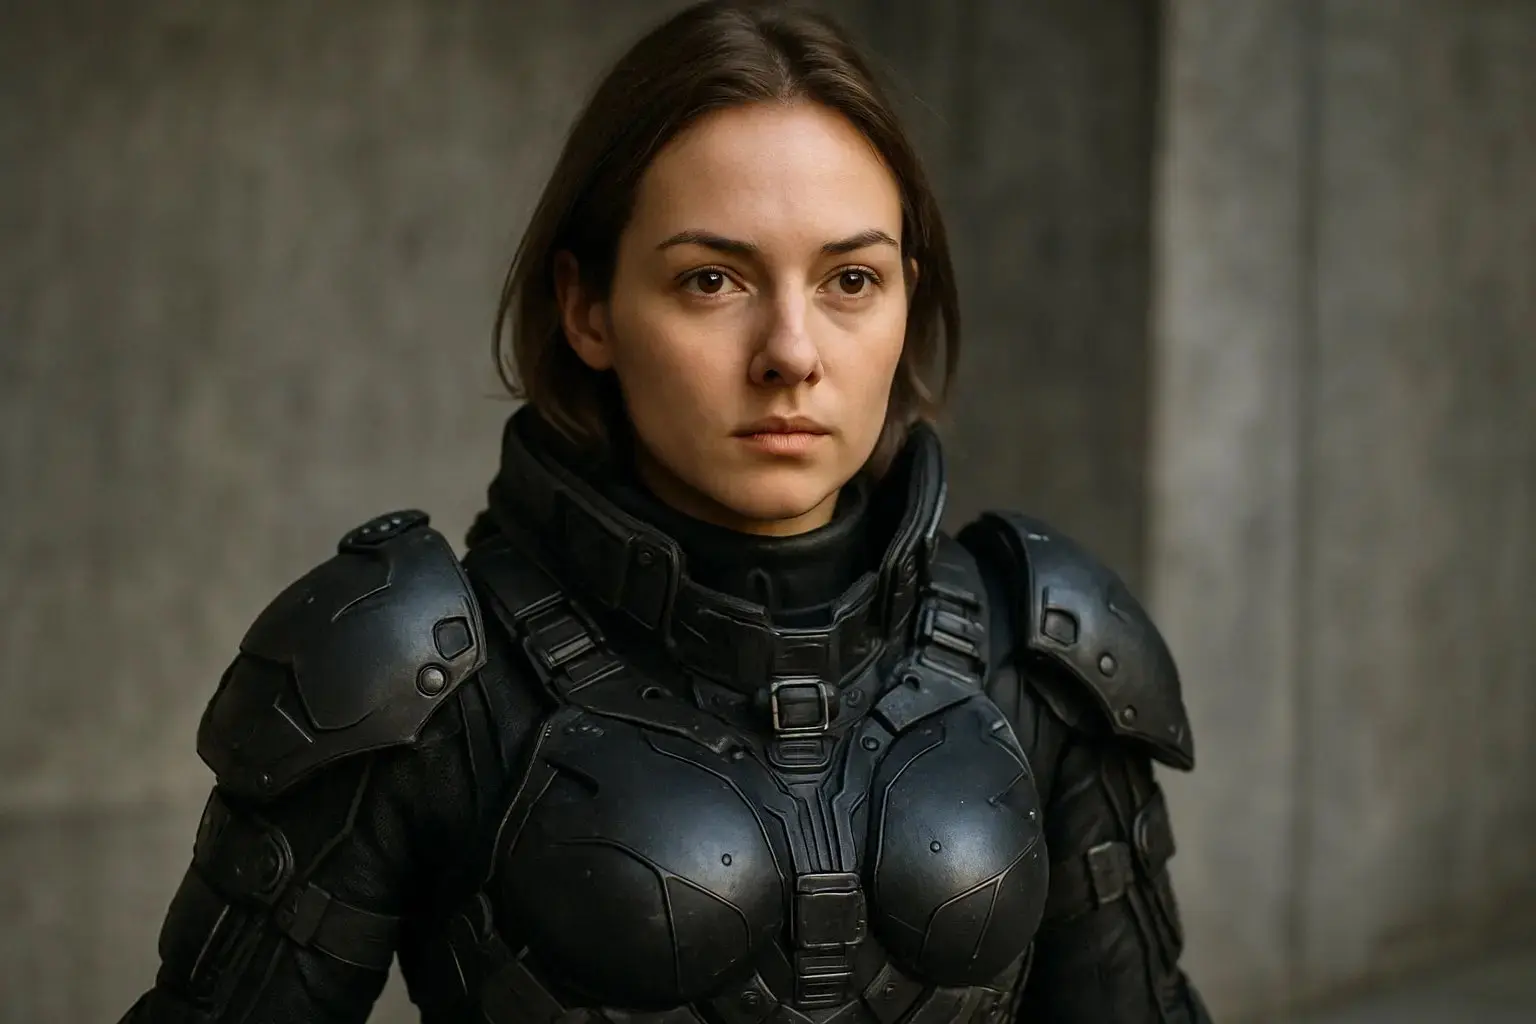
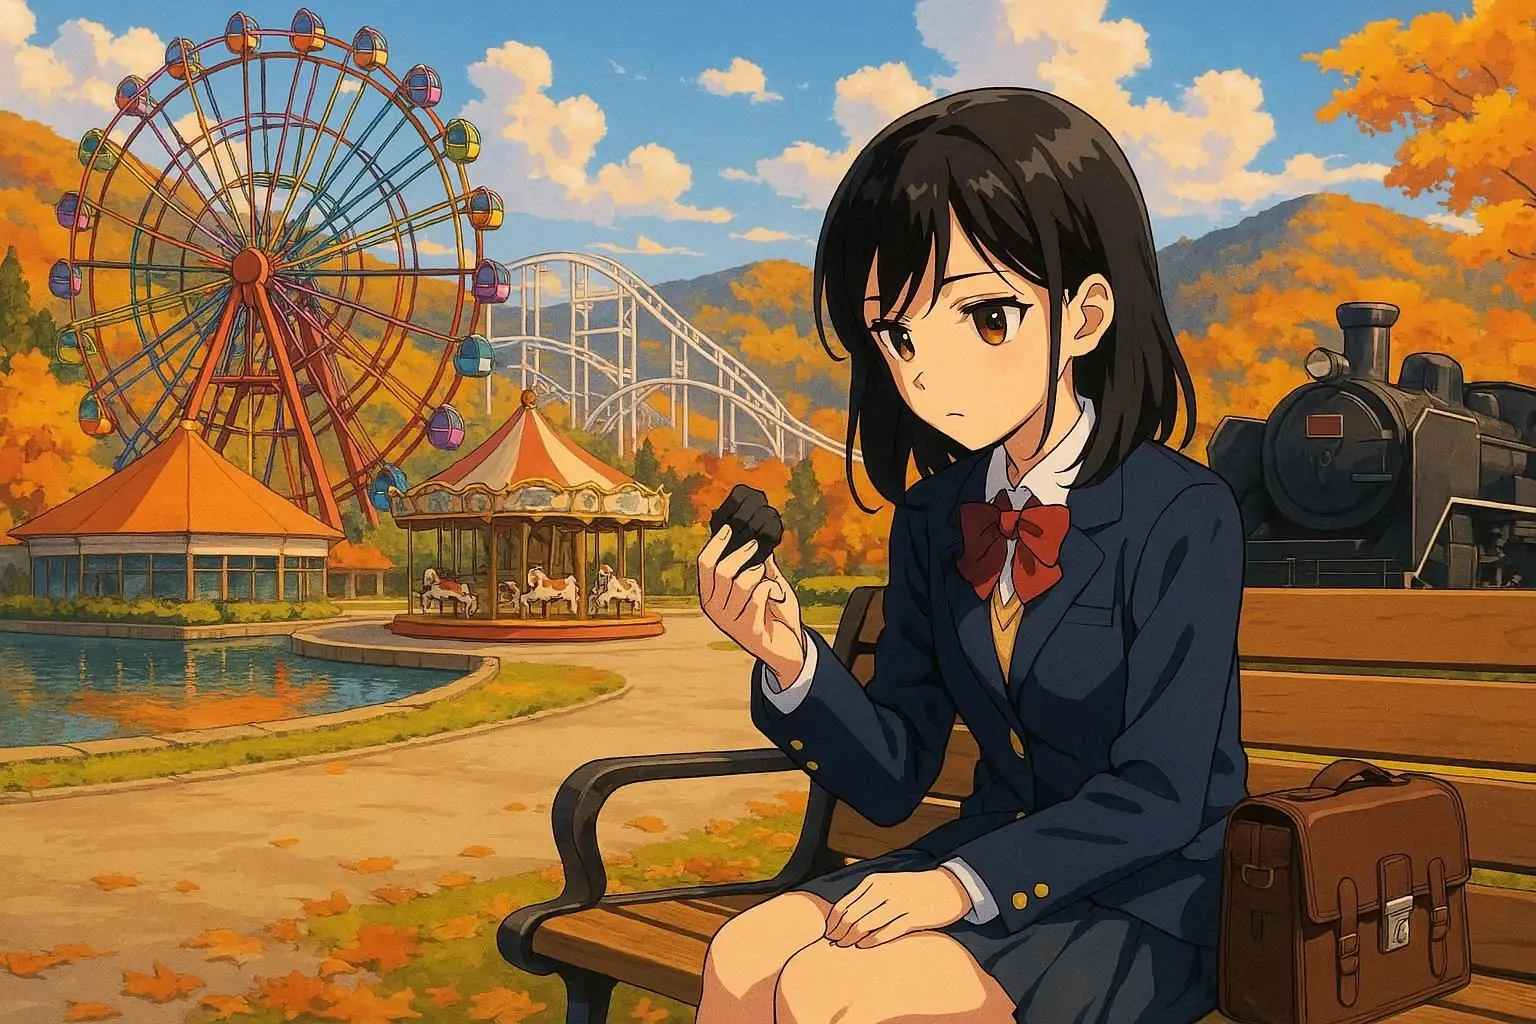
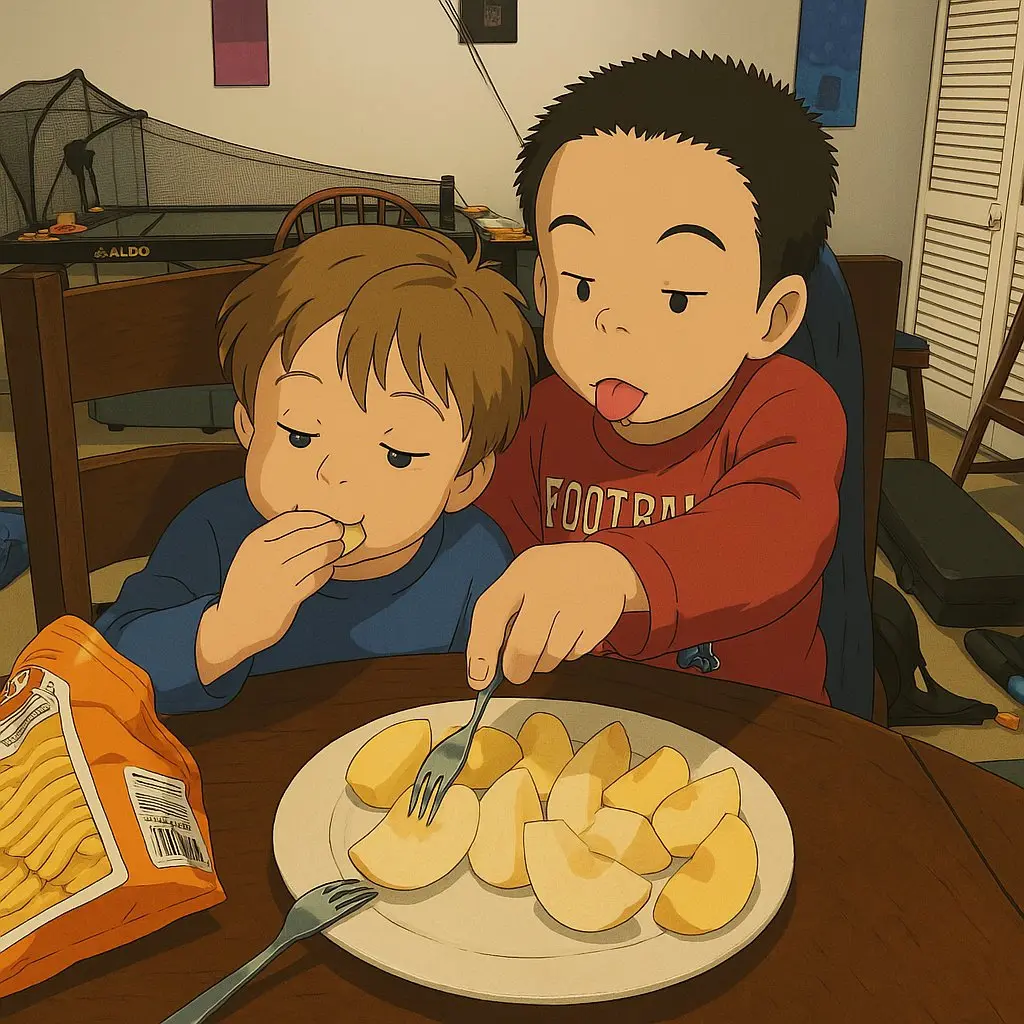
会話型画像改良
従来のワンショットジェネレーターとは異なり、GPT-4o Imageは反復的で会話型のワークフローを可能にします。自然な対話を通じて画像を改良し、以前の生成を基に構築し、複数の編集にわたってコンテキストを維持します。すべてGPT-4oのマルチモーダル理解によって実現されています。
チャットベースのイテレーション
会話を通じて画像を改良—GPT-4oはコンテキストを記憶し、以前の生成を自然に発展させます。
コンテキスト認識
モデルは一貫性のある情報に基づいた生成のために、チャット履歴、アップロードされた画像、テキストコンテキストを統合します。
自然言語コントロール
変更を会話形式で記述できます。各イテレーションでプロンプトをゼロから作り直す必要はありません。
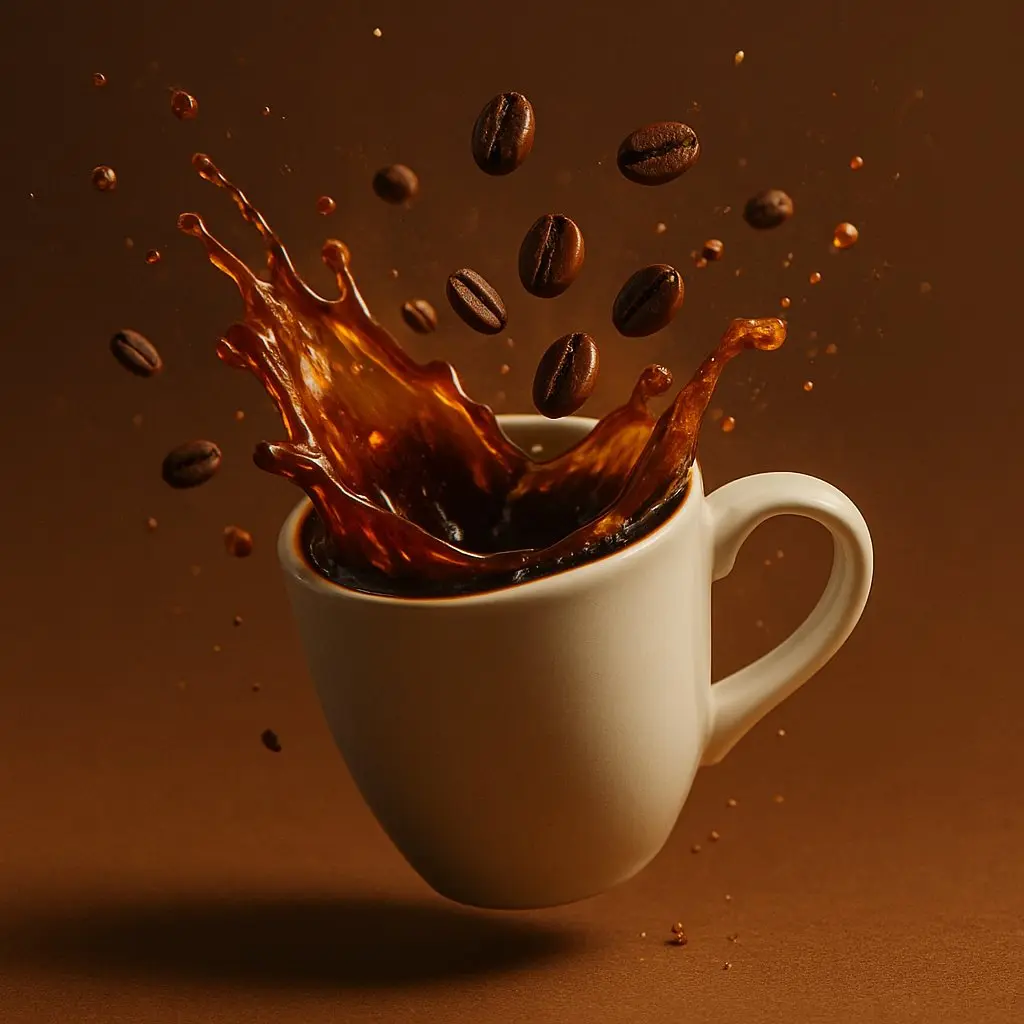
優れたテキストレンダリングとプロンプト追従性
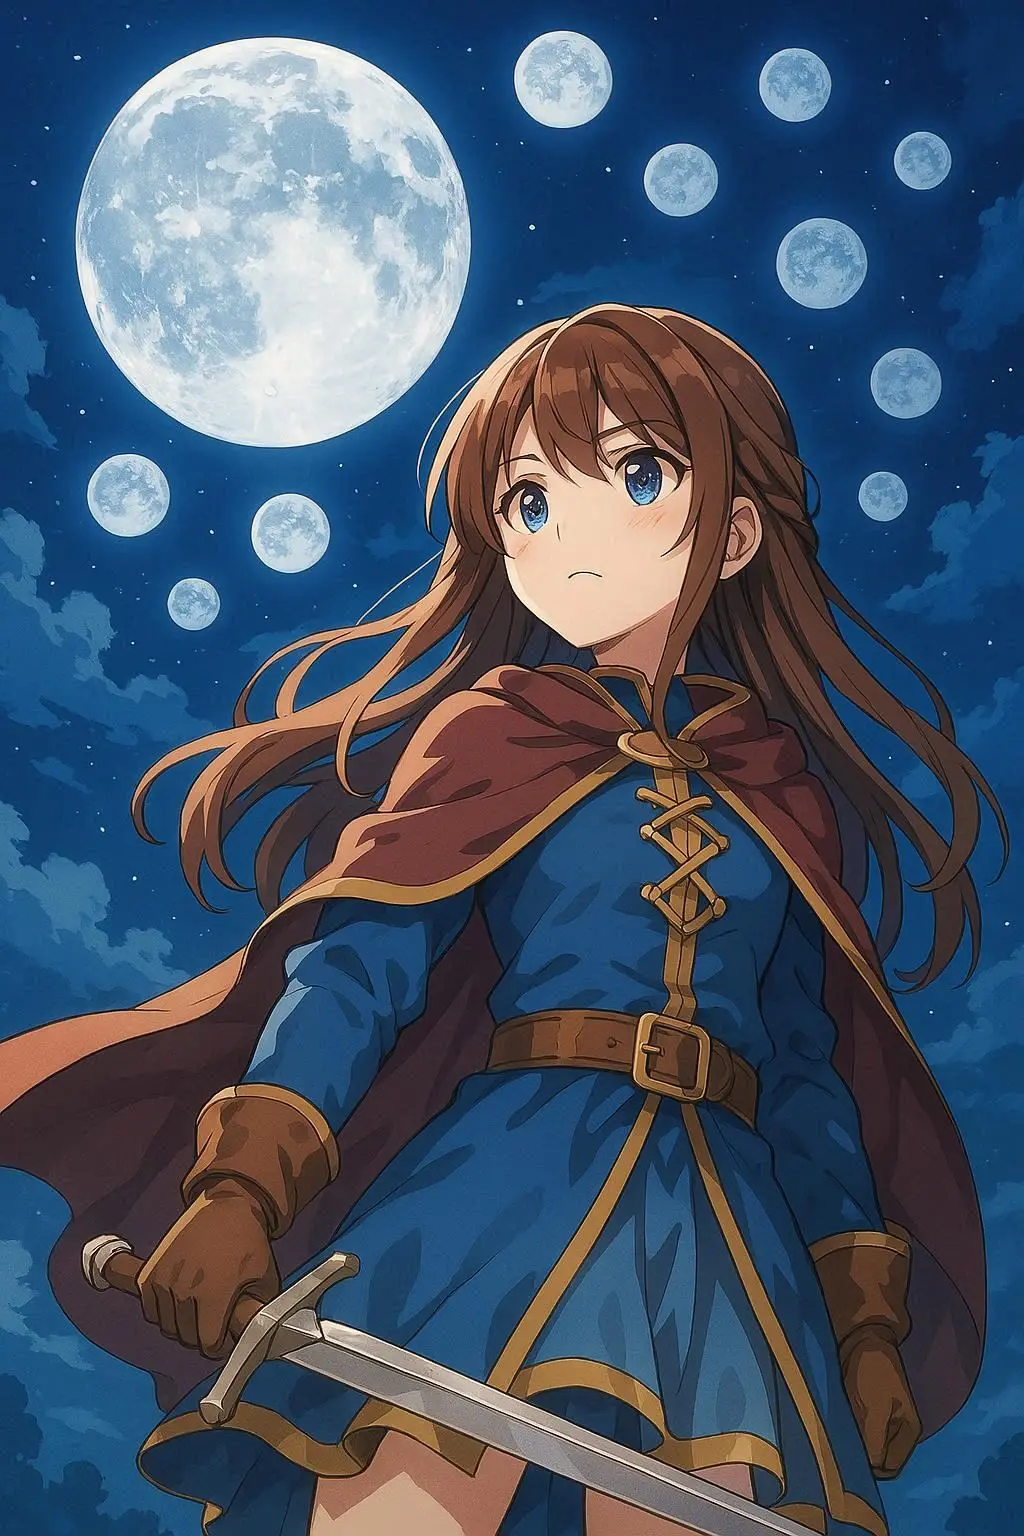
GPT-4o Imageは画像内のテキストを正確にレンダリングし、複雑なプロンプトに正確に従うことに優れています。GPT-4oの知識ベースを活用して、フォトリアリズム、イラスト、アニメ、ベクター、3D、データビジュアライゼーションスタイル全体で文脈的に正確な生成を実現します。
正確なテキストレンダリング
鮮明で読みやすいテキストを含む画像を生成—ポスター、ロゴ、インフォグラフィック、ブランドコンテンツに最適です。
マルチスタイル生成
1つのエンドポイントからフォトリアリズム、イラスト、アニメ、ベクター、3D、データビジュアライゼーションをシームレスに切り替えます。
知識に基づいた作成
GPT-4oのトレーニングにより、実世界の知識に基づいた文脈的に正確な生成が可能です。
高解像度出力と画像理解
GPT-4o搭載の機能
GPT-4o Imageを生成モデルの中でユニークにする高度な機能。
ネイティブマルチモーダル
GPT-4oの基盤上に構築され、外部ツール呼び出しではなくネイティブモダリティとして画像生成を処理します。
会話型改良
完全なコンテキスト認識を持つ自然な対話を通じて画像を改良—GPT-4oは以前の生成を記憶し、それを基に構築します。
テキストレンダリングの卓越性
ポスター、ロゴ、インフォグラフィック、ブランドグラフィックのために画像内にテキストを正確にレンダリングします。
マルチスタイル生成
同じエンドポイントからフォトリアリズム、イラスト、アニメ、ベクター、3D、データビジュアライゼーションを生成します。
4K解像度サポート
プロフェッショナルグレードの成果物と印刷対応コンテンツのために、最大4096×4096ピクセルの画像を作成します。
画像分析統合
GPT-4oが分析して視覚的コンテキストとして使用する画像をアップロードし、既存のアセットを変換したりインスピレーションを得たりします。
GPT-4o Imageの使い方
会話を通じてプロフェッショナル画像を作成・改良するための4つのシンプルなステップ:
会話を開始
自然言語でビジョンを記述します。必要に応じてリファレンス画像をアップロード—GPT-4oがその詳細を分析して統合します。
スタイルと設定を選択
スタイル(フォトリアリズム、イラスト、アニメ、ベクター、3D、データビジュアライゼーション)を指定し、解像度、アスペクト比、バリエーション数を選択します。
生成と確認
GPT-4oは知識ベースとチャットコンテキストを活用して、正確で情報に基づいた結果で高品質な画像を作成します。
対話を通じて改良
会話を続けてイテレーション—コンテキストを維持しながら、詳細を調整したり、スタイルを変更したり、以前の生成を基に構築したりします。
GPT-4o Image FAQ
OpenAIのネイティブマルチモーダル画像生成モデルに関するよくある質問。
GPT-4o Image(gpt-image-1)とは何ですか?
GPT-4o Imageは2025年4月にリリースされたOpenAIのネイティブマルチモーダル画像生成モデルです。GPT-4oの基盤上に構築され、外部モデルを呼び出すのではなくネイティブ機能として画像生成を処理し、会話型改良とコンテキスト認識型イテレーションを可能にします。
DALL-Eとの違いは何ですか?
拡散法を使用し別モデルとして動作するDALL-Eとは異なり、gpt-image-1は自己回帰生成を使用するGPT-4oのマルチモーダルアーキテクチャにネイティブです。これにより、会話型ワークフロー、コンテキスト認識、チャット履歴とのシームレスな統合が可能になります。
会話を通じて画像を改良できますか?
はい。GPT-4o Imageは自然な対話を通じた反復改良を可能にします。モデルはチャットコンテキストと以前の生成を記憶し、毎回ゼロから始めるのではなく会話を通じて画像を構築できます。
どのスタイルを生成できますか?
GPT-4o Imageは1つのエンドポイントから複数のスタイルをサポートしています:フォトリアリズム、イラスト、アニメ、ベクターアート、3Dレンダリング、データビジュアライゼーション。プロンプトで希望のスタイルを指定するだけです。
テキストレンダリングはどのように機能しますか?
GPT-4o Imageは画像内のテキストを正確にレンダリングすることに優れており、ポスター、ロゴ、インフォグラフィック、ブランドコンテンツに最適です。テキストは鮮明で読みやすく、プロンプトに正確に従います。
どの解像度がサポートされていますか?
モデルはプレゼンテーションや高解像度ディスプレイに適した、プロフェッショナルグレードで印刷対応の最大4096×4096ピクセル(4K解像度)の画像を生成します。
リファレンス画像をアップロードできますか?
はい。GPT-4oが分析して理解に統合する画像をアップロードできます。モデルはアップロードされた画像を変換したり、スタイルと構図のガイダンスのための視覚的インスピレーションとして使用したりできます。
画像を商用利用できますか?
はい。生成されたすべての画像は、ロイヤリティなしでマーケティングキャンペーン、製品、ウェブサイト、ソーシャルメディア、クライアントプロジェクトで商用利用できます。
OpenAIのマルチモーダルAIで作成
会話型画像生成、マルチスタイル作成、コンテキスト認識型改良にGPT-4o Imageを使用するクリエイターの仲間入りをしましょう。